
这篇文章解释手写数字项目的 C 实现,但首先要区分两个同名版本:旧压缩包里是线性 Softmax 分类器,独立下载文件已经是带 128 个 ReLU 隐藏单元的 MLP。两者都以 Softmax 输出十类概率,因此保留原文章标题与链接;模型内部结构、学习率和可复现边界则必须分别说明。
2026-09-08 核对:本文比对了公开下载文件的字节、阅读了两份源码,并编译原始独立源码执行有限的函数测试。没有重跑 42,000 条样本的完整训练,不报告新的准确率,也没有覆盖旧源码、模型或提交文件。
一、你下载的是哪一份 C 程序
独立源码与旧项目压缩包中的文件名都叫 digit_softmax_classifier.c,但内容不同。下面的 SHA-256 只显示前 12 位;完整值见文件核对记录。
| 版本 | 层宽 | SGD 配置 |
|---|---|---|
| 旧包内源码 | 784 → 10 | 20 轮 学习率 0.01 |
| 独立源码 | 784 → 128 → 10 |
20 轮 学习率 0.005 |
旧包内源码哈希前 12 位是 88b8953bac9f,有 7,850 个参数;独立源码是 eddd081ee163,有 101,770 个参数。两者输出层都使用 Softmax,独立源码另外包含 ReLU 隐藏层。
两份程序都使用单样本 SGD 和固定数据顺序,没有单独验证集,也没有每轮洗牌或 mini-batch。独立 MLP 的权重数组是 W1[128][784]、b1[128]、W2[10][128] 和 b2[10]。参数数目是 128*784+128+10*128+10=101770,不能继续按线性模型的 W[10][784] 解释全部源码。
二、把输入、隐藏层和输出层对上
旧版本直接计算每个类别的线性分数。以下片段对应旧包中的线性路径:
z[k] = b[k];
for (int j = 0; j < FEATURES; j++) {
    z[k] += W[k][j] * x[j];
}
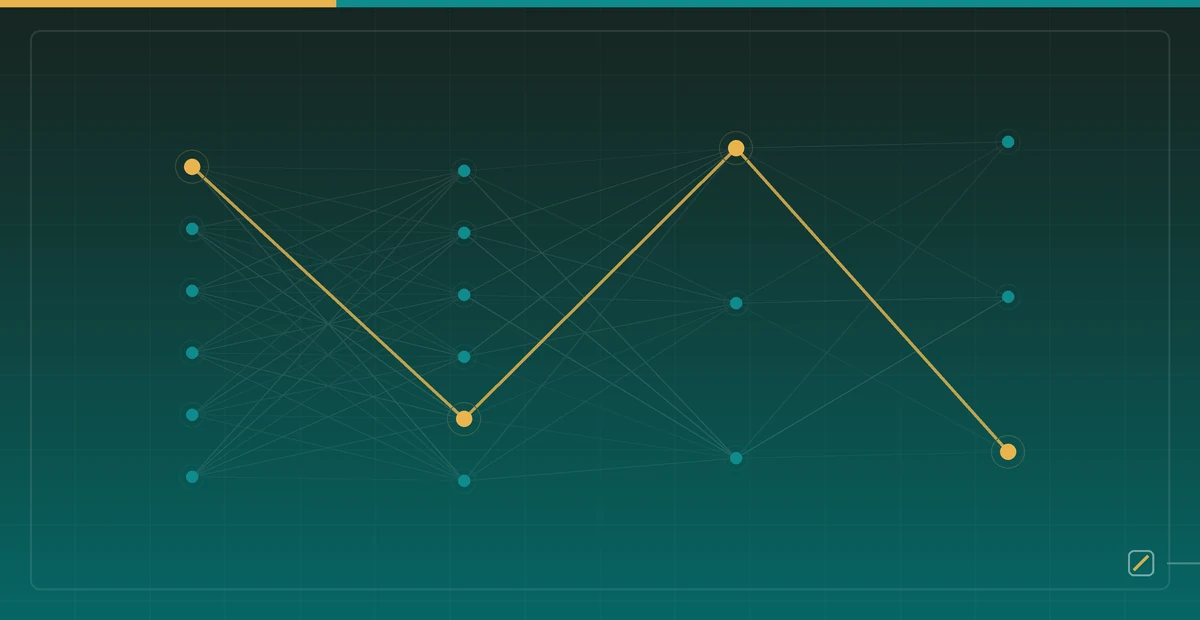
独立版本先求隐藏层,再求输出层。用列向量表示,前向传播是:
x:   784 normalized pixels
z1 = W1*x + b1       shape 128
a1 = max(0, z1)      ReLU, elementwise
z2 = W2*a1 + b2      shape 10
p  = softmax(z2)     shape 10
像素输入都按 /255.0 缩放。Softmax 前的 z2 是 logits,输出 p 是十个类别间归一化的分数。预测函数选择最大概率类别;它没有“不是数字”这一类,也不会因为画板空白自动拒绝预测。概率和接近 1 只验证归一化,不验证分类是否正确。
三、梯度更新为什么要保存旧权重
在线性版本中,单样本交叉熵的误差信号为 p[k]-onehot(y)[k],源码直接按像素更新:
double error = p[k] - (k == y_train[i] ? 1.0 : 0.0);
for (int j = 0; j < FEATURES; j++) {
    W[k][j] -= LEARNING_RATE * error * X_train[i][j];
}
b[k] -= LEARNING_RATE * error;
例如,一个明确假设的算例取真实标签 7、p[3]=0.62、p[7]=0.21、某像素 x[j]=0.4。对应梯度为 0.248 与 -0.316;在线性版本的学习率 0.01 下,权重改变量是 -0.00248 与 +0.00316。这些是教学输入,不是某次真实训练记录。
MLP 的输出层使用隐藏激活 a1,而不是直接使用像素。其反向传播可写为:
dz2 = p - onehot(y)
dW2 = dz2 * a1^T
db2 = dz2
dz1 = (W2^T * dz2) * (z1 > 0)
dW1 = dz1 * x^T
db1 = dz1
这里计算 dz1 必须使用这次前向传播时的 W2。独立源码先计算 da1 和 dz1,再更新 W2 和 W1,顺序符合这个要求。如果把 W2 更新提前,传播到隐藏层的梯度就来自另一组参数。ReLU 在 0 处的导数按源码的 z1 > 0 约定取 0。
四、减最大值还不够:区分概率与损失稳定性
两份源码都在指数运算前减去最大 logit。对于有限输入,这避免指数正向溢出;浮点数下极小项仍可能下溢为 0。含 NaN 或无穷大的输入不能靠这一操作自动修好。不能仅凭 loss 突然异常就排除学习率、坏数据、索引和参数污染等原因。
本次通过测试壳直接调用独立源码中的原函数,没有替换它。编译器是 Apple Clang 21.0.0,使用 -std=c11 -Wall -Wextra -O2,编译无警告。结果如下:
| 输入或检查 | 实测输出 | 含义 |
|---|---|---|
[1000,-1000] |
概率 [1,0] |
较小指数下溢为 0 |
| 真实类别 1;源码日志公式 | 损失 34.538776 |
-log(p[y]+1e-15) 掩盖了更大的损失 |
| 同一输入;logsumexp 形式 | 损失 2000 |
保留错误类别的 logit 差距 |
[+inf,0] |
输出不是有限数 | 必须先检查输入有限性 |
源码日志采用加 epsilon 的损失,而更新使用 p-onehot。后者对应标准交叉熵的 logit 梯度,并不是加 epsilon 后表达式在所有数值范围内的精确梯度。因此,极端情况下不能把那条打印曲线当作标准交叉熵的忠实记录。
下面是独立的稳定损失教学程序,未修改原 C 文件。它在同一固定输入上输出 2000。其方法与 logsumexp 的数值计算思路一致,但此程序只使用 Python 标准库,没有调用 SciPy。
完整的稳定交叉熵示例
"""A finite-logit cross-entropy example; no model training or dependencies."""
import math


def cross_entropy(logits, label):
    if not logits or type(label) is not int or not 0 <= label < len(logits):
        raise ValueError("nonempty logits and a valid integer label are required")
    if any(not math.isfinite(z) for z in logits):
        raise ValueError("logits must be finite")
    maximum = max(logits)
    shifted_sum = sum(math.exp(z - maximum) for z in logits)
    return (maximum - logits[label]) + math.log(shifted_sum)


if __name__ == "__main__":
    loss = cross_entropy([1000.0, -1000.0], 1)
    assert loss == 2000.0
    print("logsumexp cross-entropy:", loss)
显式拒绝非有限 logits 不等于对任意极端浮点范围都有有限损失保证;如果最大值与真实类别分数的差本身超出浮点表示范围,结果仍可能为无穷大。这里证明的是给定反例,不是全面数值认证。
五、训练日志不等于验证结果
每轮日志累加的是各样本在更新前的预测,遍历过程中权重不断变化。它不是“本轮结束后的同一模型”在整份训练数据上的指标。最后的 evaluate_model 才用固定的最终参数重新遍历训练集,并输出训练准确率和混淆矩阵;仍然不是验证集或无标签测试集的成绩。
混淆矩阵能提示哪些标签被错分,但不能单凭它断言模型容量已到上限。先排查数据映射、标签、分布差异和优化过程,再比较模型。若要报告泛化效果,需要固定验证行号、训练参数、预处理、随机状态与模型文件,保留逐样本预测;本次不把缺失的训练记录补写成已完成实验。
六、隔离运行目录,不覆盖已有提交文件
按实验包 README 准备 digit-assets 后,可先执行只读检查和原函数测试:
python3 audit_digits.py --assets ../digit-assets --out ../digit-results
python3 run_c_probe.py --source ../digit-assets/digit_softmax_classifier.c --out ../digit-results
python3 stable_ce.py
run_c_probe.py 会核对源码完整哈希,编译一个替代入口,只测试 Softmax 和 CSV 分词函数,不调用原训练 main。以下才是完整训练命令,在另一个新目录执行;本轮没有运行该训练:
set -e
mkdir ../digit-mlp-run
cd ../digit-mlp-run
unzip ../digit-assets/train.csv.zip
unzip ../digit-assets/test.csv.zip
cc -std=c11 -Wall -Wextra -O2 ../digit-assets/digit_softmax_classifier.c -lm -o digit_classifier
./digit_classifier
程序按当前工作目录查找数据,最后会写入或覆盖该目录的 submission.csv。仅训练/测试像素的静态 double 数组就约占 419 MiB,不能把完整训练与小函数测试的资源需求混为一谈。固定 srand(42) 也不保证跨 C 运行库得到完全相同的随机序列。
七、同架构不等于同一个训练产物
独立浏览器 JSON 与独立 C 源码的 MLP 形状一致,但这份 C 文件没有导出 JSON 权重的代码。旧包中的浏览器模型又有不同训练配置。已有 submission.csv 在旧包与独立下载中完全相同,不能凭它证明当前 MLP 训练已被复现。需要导出脚本、检查点、划分和运行日志,才能建立这条来源关系。
完整结果见 C 函数测试记录;可复跑源码与记录在 实验包,运行说明见 README。继续阅读 数据结构与严格检查、浏览器版本与概率边界,或打开 实验台和原下载区。