电池建模与 AI
这个专题关注电池模型、仿真数据和机器学习之间的连接。传统电池建模强调电化学机理、参数、实验条件和数值求解;AI 方向则关注如何把仿真结果、EIS 特征、老化标签和运行元数据整理成可训练、可验证的数据集。
本站不会把电池 AI 写成“把数据丢给模型”的流程。更重要的问题是:数据标签从哪里来,SOC、温度、循环次数和参数扰动如何影响结果,训练/测试切分是否泄漏,模型预测 SOH 或 RUL 时能否解释边界条件。
阅读路线
建议先理解 PyBaMM 的模型结构和 ParameterValues,再进入 EIS 数据生成、阻抗特征、老化仿真和机器学习标签。这样你能先知道仿真数据的物理含义,再判断哪些特征适合送入模型。对 AI 读者来说,这条路线可以补足电池领域背景;对电池建模读者来说,它展示了如何把模型输出整理成可复现的数据管线。
文章分成两条路线。数据管线从 PyBaMM 架构、EIS 标签、老化数据集走到 SOH/RUL 训练。静默错误实测逐篇检查参数集、Experiment、热模型、容量定义、SEI 与析锂、求解器收敛和参数拟合:多数问题不会报错,只会交回看似正常的错误结果;求解器一篇讲的是模拟真正崩溃时,如何分清数值问题和物理问题。每篇文章第一节之前的系列导航会标出它所在的路线和位置。
每篇文章都会尽量说明实验前提,例如仿真参数、SOC sweep、频率范围、采样方式、标签定义和指标。真实电池系统远比教学示例复杂,因此本站材料适合学习和研究,不应被直接当作生产级 BMS 决策依据。
复现与风险边界
- 记录 PyBaMM、Python、NumPy 和 scikit-learn 版本。
- 区分仿真数据、公开数据和真实设备数据的适用范围。
- 检查训练/测试划分是否按电池、循环或时间隔离。
- 不要把教学模型输出直接用于安全关键或商业决策。
什么样的数据集才有用
电池 AI 数据集不是行数越多越有价值。真正有用的数据应该说明仿真或测量条件、模型或设备来源、参数扰动方式、阻抗频率范围、SOC 和温度窗口、循环或时间索引,以及标签的精确定义。缺少这些信息时,模型可能学到的是数据生成捷径,而不是能迁移到不同电芯、温度、工况或验证拆分的规律。
对于教学仿真数据,还需要说明生成目的。它是用于解释特征提取、比较数据拆分、训练回归模型,还是观察某个物理趋势?目的不同,数据的使用方式和限制也不同。本站会尽量把这些背景写在数据和模型说明旁边,而不是只提供一个 CSV 或模型分数。
验证问题
在相信一个电池预测流程之前,先问验证集到底隔离了什么因素。随机按行切分通常只测试同一仿真范围内的插值能力;按电芯、参数、循环、时间或温度切分,才更接近模型能否面对新条件。讨论 SOH、RUL、EIS 特征或老化标签时,文章会尽量明确当前验证问题是哪一种。
这个专题也会区分科学解释和工程部署。监督学习模型可以帮助探索哪些特征与仿真老化标签相关,但生产级 BMS 决策需要传感器验证、安全评审、领域校准、监控和独立测试。这个边界是正文内容的一部分,不是页脚里的免责文字。
数据集审计表
| 审计项 | 为什么重要 | 页面应说明的内容 |
|---|---|---|
| 工况条件 | 模型可能只学到特定 SOC、温度或倍率范围。 | SOC window、温度、倍率、循环范围、频率范围。 |
| 标签来源 | SOH/RUL 标签如果定义不清,评估没有可解释性。 | 标签公式、阈值、时间索引、仿真或实测来源。 |
| 切分方式 | 随机行切分可能把同一电芯或同一参数泄漏到测试集。 | 按行、按电芯、按循环、按温度或按参数隔离的说明。 |
| 适用边界 | 教学仿真不能自动代表真实 BMS 部署。 | 传感器误差、域差异、安全评审和独立验证要求。 |
专题路线
电池建模与 AI 数据专题
从 PyBaMM 架构、EIS 阻抗谱到老化仿真数据工厂,建立可追溯、带标签、可训练 AI 模型的电池数据路线。
面向搜索 PyBaMM、Oxford 电池模型、EISSimulation、SOH/RUL 标签、LLI/LAM 和电池 AI 数据生成的博士生和研究工程师。
专题说明
为什么这些文章放在同一条路线里
电池建模专题强调可追溯数据,而不是把仿真曲线直接当成真实实验结论。文章会区分模型参数、实验协议、频域阻抗、老化状态和 AI 标签之间的关系。
PyBaMM 文章先解释建模管线和 EISSimulation,再进入老化数据生成、SOH/RUL 标签和回归训练。每一步都保留 manifest 或质量报告,方便复查数据泄漏和域外泛化风险。
你会完成什么
你会读懂 PyBaMM 的建模管线,运行阻抗与老化样例,并训练 SOH/RUL 回归模型。
推荐阅读顺序
先建立概念,再进入可运行项目
PyBaMM 快速解读:从 Oxford 电池模型架构到 AI 数据管线
面向博士生拆解 PyBaMM expression tree、Simulation 管线、模型选项和 AI 数据 schema。
PyBaMM 18 个内置参数集实测:四种静默出错的方式
把同一组实验在 PyBaMM 26.5 的 18 个内置参数集上全跑一遍。报错的不是问题,问题是能跑完却是错的:默认参数集的 "1C" 实际只有 0.78C,Chen2020 在 −10°C 下容量只掉 0.6%,实验字符串会把磷酸铁锂充到 4.2V 且零警告,SEI 能跑但用的是借来的示例参数。附一段可直接运行的检查代码。
PyBaMM Experiment 跑完了却是错的:五个实测陷阱
PyBaMM 的 Experiment 几乎从不报错,下面五个问题都会让实验正常跑完、交回错误结果:安培写的步骤到 24 小时静默截断,平铺列表让循环寿命被高估 4 倍,save_at_cycles 留下 None,period 不影响精度却会让自己的积分出错,initial_soc=1 不等于 4.2V。附检查实验是否真正跑完的函数。
PyBaMM 热模型实测:产热为零、缺失的熵热与从 25 °C 开始的低温仿真
PyBaMM 的热模型打开就能跑,下面这些设置都不会报错:等温模型的产热变量恒为零,四个参数集的熵系数为零、可逆热整项缺失,四个参数集把电池写成一张两面散热的极片,只设环境温度的低温仿真其实从 25 °C 开始。8 个参数集实测,附检查函数。
PyBaMM 的容量衰减到底在量什么:80% capacity、Capacity [A.h] 与 Loss of capacity 实测
PyBaMM 里至少有几种不同的“容量”,退化研究常常不自觉地混用:80% capacity 终止条件比的是零电流 eSOH 容量而不是实测放电,汇总变量读的是每个循环最后一刻的状态,Loss of capacity to X 其实是锂而不是容量,默认参数集 Marquis2019 失锂后容量反而上升。PyBaMM 26.5 实测,附检查函数。
PyBaMM SEI 与析锂实测:按时间老化的 SEI、占位速率常数、温度与孔隙堵塞
PyBaMM 里决定衰减曲线形状的选择都不会报错:OKane2022 的 SEI 只随时间增长,静置长短改变的是循环次数而不是寿终日期;SEI 速率常数是通用占位值,换模型差 450 倍;除 OKane2022 外活化能全为零;低温析锂堵孔在默认网格上高估 5 倍;irreversible 析锂在静置时也会沉积。PyBaMM 26.5 实测,附预检函数。
PyBaMM 阻抗谱数据生成:EISSimulation、SOC sweep 与 AI 标签
用 PyBaMM core 的 EISSimulation 生成阻抗谱,提取 Nyquist/Bode 特征并对齐老化标签。
用 PyBaMM 生成电池老化与阻抗 AI 数据集:标签、切分和质量控制
构建可复现 PyBaMM 数据工厂,生成 SOH、RUL、LLI、LAM、plating 和 EIS 特征标签。
训练电池 AI 实例:用 PyBaMM 仿真数据预测 SOH 与 RUL
用 PyBaMM 或 surrogate 生成的 EIS 特征和工况数据训练 scikit-learn 模型,预测电池 SOH 与 RUL。
PyBaMM 求解器收敛失败:先分清数值问题还是物理问题
长时间退化模拟在第 300 圈崩掉时,调容差通常是错的方向。用 SPMe 对照判定是数值还是物理问题,附 IDAKLU 全部选项默认值与一个静默失效的陷阱。
PyBaMM 参数拟合:为什么优化器给你的数字可能毫无意义
搜索排第一的 pybamm-param 已废弃、PyBOP 的 API 刚大改,而真正要命的是可辨识性:参数在方程里以组合出现,一条曲线分不开它们。附一套区分"拟合出来"与"编出来"的验证流程。
资源与分发素材
代码、数据、图示和可分享摘要集中管理
电池建模与 AI / GUIDE
PyBaMM AI Data Lab 说明
说明 PyBaMM 电池建模与 AI 数据管线的安装、quick run、backend 和输出 schema。
电池建模与 AI / ARCHIVE
PyBaMM AI Data Lab 完整实验包
打包设计生成、老化 sweep、EIS sweep、标签构建、质量检查、样例 CSV 和图示。
电池建模与 AI / DATASET
PyBaMM 样本 manifest
保存 sample_id、模型族、参数集、协议、温度、SOC、cycle、split group 和标签来源。
电池建模与 AI / DATASET
PyBaMM EIS 样例谱 CSV
频点级阻抗输出,包含 frequency、Z_re、Z_im、幅值、相位、backend 和 solver status。
电池建模与 AI / DATASET
电池老化与阻抗标签 CSV
保存 SOH、RUL proxy、LLI、LAM、plating、local resistance 和 EIS 特征。
电池建模与 AI / DATASET
PyBaMM AI 数据质量报告
记录重复 sample、频点重复、缺失标签、split leakage 和 backend 使用情况。
电池建模与 AI / DATASET
SOH/RUL 训练指标 CSV
保存 group split、MAE、RMSE、R2、label source 和 backend used,用于复查训练结果。
电池建模与 AI / DATASET
SOH/RUL held-out 预测 CSV
保存测试样本的真实值、预测值和绝对误差。
电池建模与 AI / DATASET
SOH/RUL 特征重要性 CSV
记录每个目标模型的随机森林特征重要性。
电池建模与 AI / DIAGRAM
PyBaMM 到 AI 数据管线图

展示设计网格、老化求解、EIS 求解、标签构建、质量门和 AI split。
电池建模与 AI / DIAGRAM
EIS 特征与标签 schema 图

把频点、阻抗特征、工况 metadata 与 SOH/RUL/退化模式标签连接起来。
电池建模与 AI / DIAGRAM
老化标签样例图
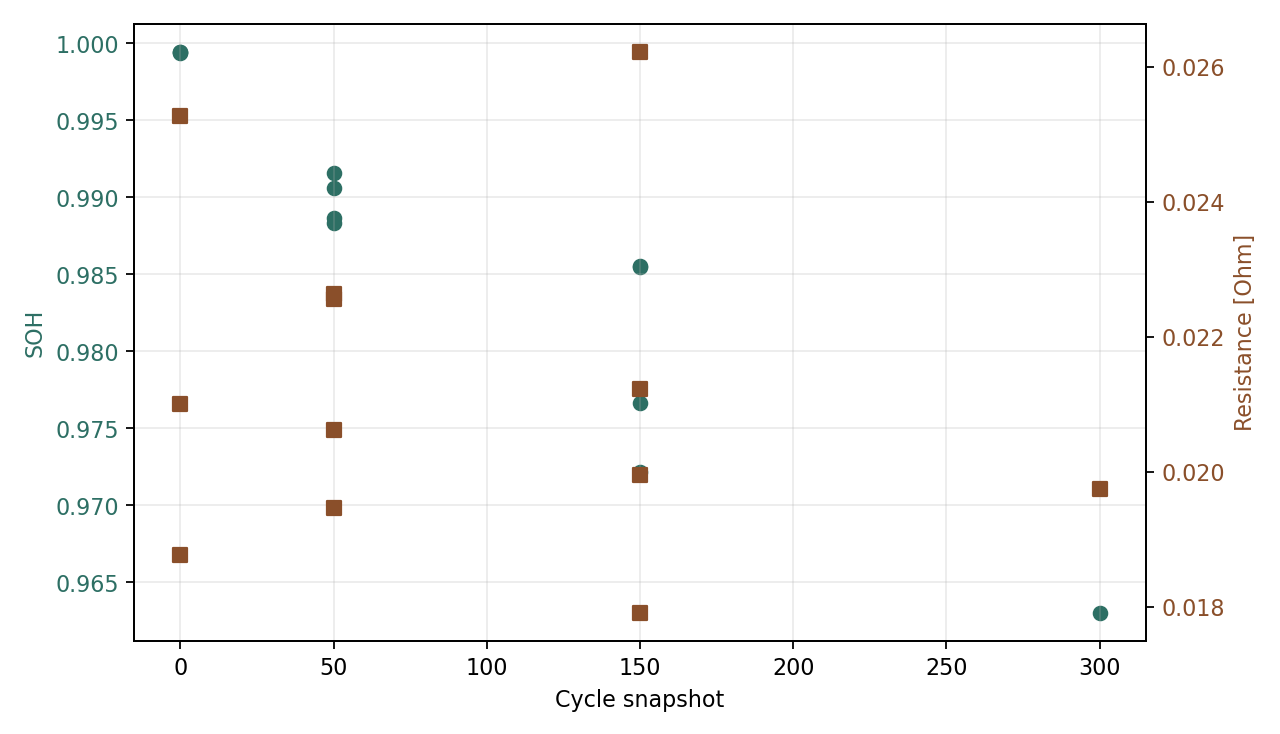
样例展示 cycle snapshot、SOH 与 local ECM resistance 的标签变化。
电池建模与 AI / DIAGRAM
SOH/RUL 训练结果图
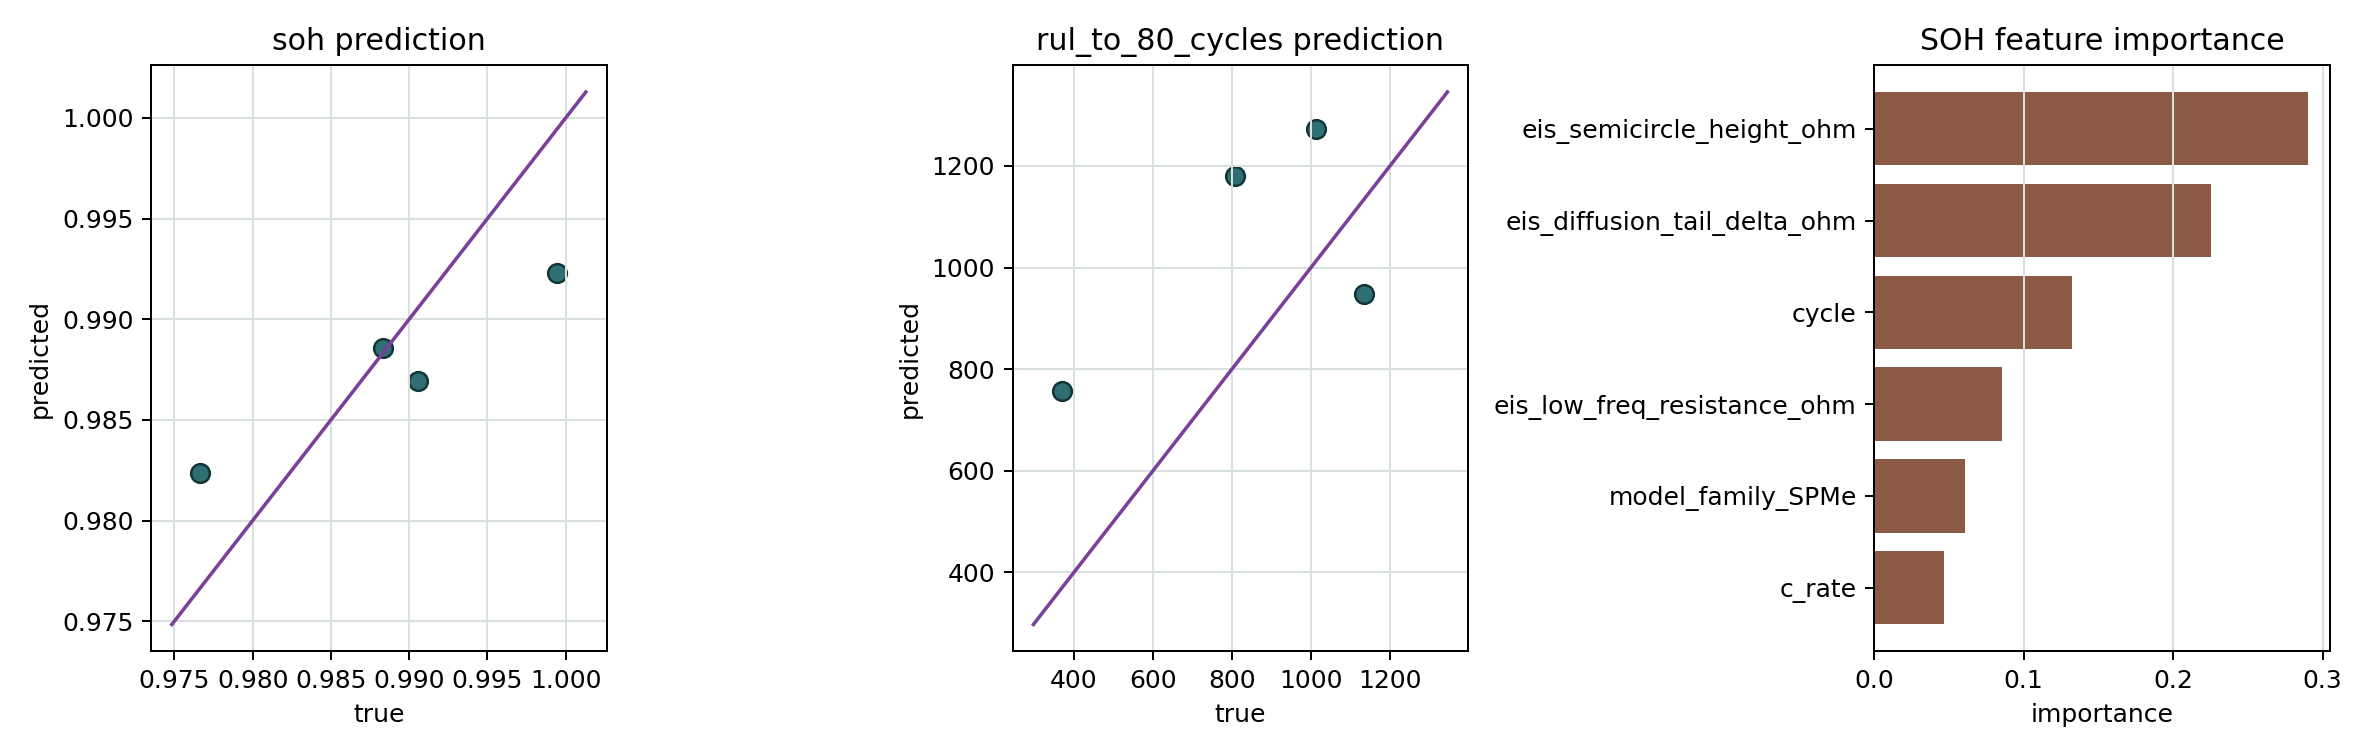
展示 held-out SOH/RUL 预测散点图和 SOH 特征重要性。
电池建模与 AI / SOCIAL
电池建模与 AI 分享图

面向 PyBaMM 电池建模、EIS、老化仿真和 AI 数据专题的 OG 分享图。
常见问题
把搜索问题直接回答清楚
这些数据能直接替代真实电池实验吗?
不能。它们是 physics-based synthetic data,适合预训练、管线验证和实验设计;真实结论仍需要实验校准和域外验证。
为什么不用旧 pybamm-eis 包?
旧仓库已归档,当前文章和实验包默认使用 PyBaMM core 的 pybamm.EISSimulation。
为什么要按 cell_design_id 或 protocol_id 切分?
同一仿真轨迹的频点和 cycle snapshot 高度相关,随机按行切分会造成数据泄漏。