
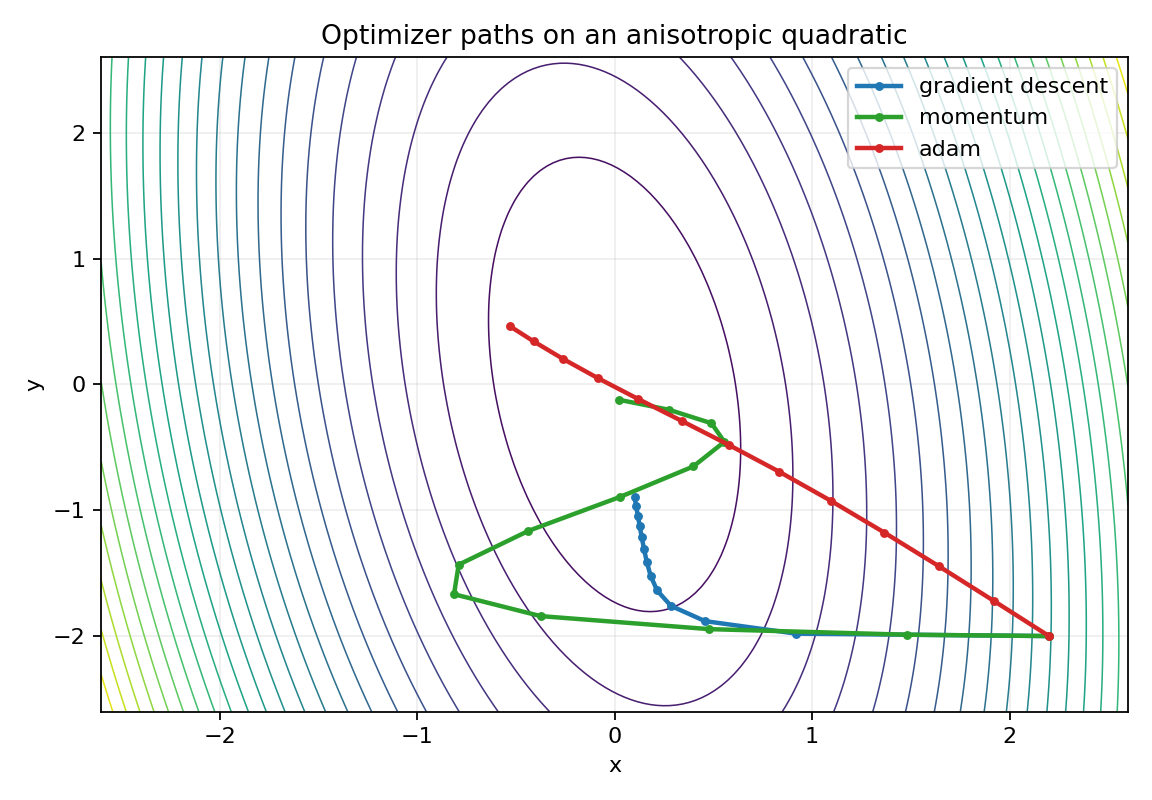
同一个起点,梯度下降、Momentum 和 Adam 为什么走出不同路径?这篇文章用一个能手算、能检查稳定性边界的二维二次函数回答这个问题。重点不是选出“最好的优化器”,而是把坐标变化、历史状态和损失曲线对应起来,检查哪些解释真的得到数据支持。
实验范围:固定目标函数、float64、起点 [2.2, -2.0]、12 次确定性更新,没有数据采样、神经网络或 GPU。本文代码已与原等高线配套的 39 行轨迹核对。更新于 2026-09-08;修正了旧版代码与配图参数不一致、Adam 单调下降和 warmup 必须使用等不准确表述。
页面顶部的运行说明对应旧 deep-learning-math-lab 包,用于复现原等高线。本文新增的状态追踪、负对照和检查使用独立的 optimizer-audit-lab 包,下载与命令见第五节;两个包不要混用运行路径。
一、先算曲率,再解释路径
L(x, y) = 0.5 * (8*x*x + y*y) + 0.8*x*y
grad L = [8*x + 0.8*y, y + 0.8*x]
H = [[8, 0.8], [0.8, 1]]
theta* = [0, 0], L(theta*) = 0
Hessian 的特征值约为 0.909735 和 8.090265,均为正,因此原点是唯一最小点。条件数约 8.892987:两个主方向的曲率不同,但没有必要把它夸大成极端病态问题。由于交叉项存在,主方向也不完全等于 x、y 轴。
更重要的是,这里的 Hessian 处处相同。曲线拐弯不能解释成“优化器适应了不断变化的曲率”;变化的是当前位置的梯度,以及优化器累积的状态。这是确定性梯度下降,文中不把它误称为含小批量噪声的 SGD 实验。
| 方法 | 固定配置与第 12 步结果 |
|---|---|
| GD | lr=0.08;终点 [0.101159, -0.896491];loss=0.370230;12 次更新中没有损失上升。 |
| Momentum | lr=0.045,beta=0.75,初始速度为零;终点 [0.022978, -0.122060];loss=0.007317;第 3、4、8、9 步损失上升。 |
| Adam | lr=0.28,betas=(0.9, 0.999),eps=1e-8,初始矩为零并做偏差修正;终点 [-0.529374, 0.462135];loss=1.032020。 |
这些学习率是图中原有的演示配置,不是等预算调参得到的最佳值。Momentum 在第 12 步损失最低,只说明这一固定窗口的结果;没有测试泛化、计算耗时或其他目标函数。
二、第一步与真正的稳定性边界
theta0 = [2.2, -2.0]
g0 = [16.0, -0.24]
theta1 = theta0 - 0.08 * g0 = [0.92, -1.9808]
L(theta0) = 17.84
L(theta1) = 3.88951552
对这个正定二次函数,GD 的递推可以写成 theta_t = (I - lr*H)^t theta0。沿某个特征向量的分量每一步乘上 1 - lr*lambda。因子为负代表越过该方向的零点;只有绝对值大于 1,误差才在这个方向增长。越过最小点不等于发散。
这里高曲率方向开始变号的阈值是 1/lambda_max = 0.123605,所有初值都收敛所需的严格区间为 0 < lr < 2/lambda_max = 0.247211。边界处高曲率分量不衰减;超过边界时,本实验起点含有该方向的非零分量,因此会发散。
| GD 学习率 | 特征方向因子与实测 |
|---|---|
| 0.08 | 低/高曲率因子约 0.927221 / 0.352779,均为正;第 50 步 loss=0.00118688,不存在特征方向上的正负交替。 |
| 0.20 | 因子约 0.818053 / -0.618053;高曲率方向交替,但振幅缩小;第 50 步 loss=4.31e-9。 |
| 0.26 | 因子约 0.763469 / -1.103469;高曲率方向振幅增大;第 50 步 loss=293959.665。 |
这三个 50 步检查是独立的稳定性实验,不要与上图的 12 步三方法比较混为一谈。GD 在 0.20 下可以同时出现坐标振荡与损失下降,观察时要区分这两种现象。
三、Momentum 的状态到底是什么
velocity_t = beta * velocity_(t-1) + gradient_t
theta_t = theta_(t-1) - lr * velocity_t
这里的 velocity 是未乘学习率的梯度累积量。它保留惯性,也可能在当前梯度已经换向时继续越过谷底。原图中 Momentum 有四次损失上升,所以“动量会抵消全部震荡”不是这个实验的结论。
另一种常见写法是 u_t = beta*u_(t-1) + lr*gradient_t; theta -= u_t。学习率固定且状态初始化兼容时,两者等价;学习率变化时通常不等价。实验包还给出一个固定标量梯度为 1、beta=0.9、从零开始的两步检查:学习率 [0.1, 0.01] 时,两种写法分别到达 -0.119 与 -0.200。这个检查与二次函数轨迹分开记录。
迁移代码时应核对学习率放在状态更新内还是外、是否使用 dampening,以及首步缓冲区如何初始化。PyTorch SGD 文档专门说明了这些实现约定;本文未运行 PyTorch 对照测试。
四、Adam 的归一化并不保证单调下降
m_t = beta1*m_(t-1) + (1-beta1)*g_t
v_t = beta2*v_(t-1) + (1-beta2)*g_t*g_t
m_hat = m_t / (1-beta1**t)
v_hat = v_t / (1-beta2**t)
theta_t = theta_(t-1) - lr*m_hat/(sqrt(v_hat)+eps)
v 追踪梯度平方的指数移动平均,即未中心化二阶矩,不是减去均值平方后的方差。以上更新约定对应 Adam 论文 Algorithm 1。它按历史梯度统计量缩放各坐标,并没有直接求 Hessian 的逆。
| Adam 更新步 | 本实验的坐标与损失 |
|---|---|
| 第 1 步 | [1.920000, -1.720000];loss=13.582880。两个坐标的更新幅度都接近 0.28,而不是按初始梯度 16 与 -0.24 的大小同比缩放。 |
| 第 9 步 | [-0.084274, 0.049923];loss=0.026289,是这 12 步内的最低值。 |
| 第 10 至 12 步 | loss 依次为 0.250965、0.619280、1.032020。继续更新反而远离此前的最低点;这段反弹不是长期发散的证明。 |
从零状态出发,首步偏差修正后有 m_hat=g、v_hat=g*g,因此被减去的更新为 lr*g/(abs(g)+eps),各分量绝对值不超过 lr。本例实测约 [0.28, -0.28];故意漏掉偏差修正后约为 [0.885438, -0.885437]。这说明初始化和实现细节会改变路径,不说明正确 Adam 的第一步一定会爆炸。
本例没有使用 warmup。它反驳的是“Adam 必须 warmup”的绝对说法,不能证明大型模型不需要预热,也不能把首步的幅度界推广到所有后续更新。
五、可直接运行的完整程序
下面程序与中英文实验包中的 optimizer_example.py一致。它复制输入并转为 float64,拒绝未知方法和非法超参数,返回完整轨迹与更新状态。只支持本文的二维函数,不是通用训练框架。
展开 NumPy 完整代码
"""A fixed quadratic experiment, not a training-framework implementation."""
import numpy as np

H = np.array([[8.0, 0.8], [0.8, 1.0]])
START = np.array([2.2, -2.0])
CONFIGS = {
    "gd": {"lr": 0.08},
    "momentum": {"lr": 0.045, "beta": 0.75},
    "adam": {"lr": 0.28, "beta1": 0.9, "beta2": 0.999, "eps": 1e-8},
}


def loss(theta):
    x, y = theta
    return float(0.5 * (8 * x * x + y * y) + 0.8 * x * y)


def grad(theta):
    x, y = theta
    return np.array([8 * x + 0.8 * y, y + 0.8 * x])


def scalar(value, name, lower=0, upper=np.inf, strict=True):
    a = np.asarray(value)
    if a.ndim or a.dtype.kind not in "iuf" or not np.isfinite(a):
        raise ValueError(name + " must be a finite real scalar")
    value = float(a)
    if value >= upper or (value <= lower if strict else value < lower):
        raise ValueError(name + " outside its valid interval")
    return value


def run_optimizer(method, start, lr, steps=12, beta=0.75,
                  beta1=0.9, beta2=0.999, eps=1e-8):
    if method not in CONFIGS:
        raise ValueError("method must be gd, momentum, or adam")
    raw = np.asarray(start)
    if raw.shape != (2,) or raw.dtype.kind not in "iuf":
        raise ValueError("start must be a real two-vector")
    theta = raw.astype(np.float64, copy=True)
    if not np.isfinite(theta).all():
        raise ValueError("start must be finite")
    if isinstance(steps, (bool, np.bool_)) or not isinstance(steps, (int, np.integer)) or steps < 0:
        raise ValueError("steps must be a nonnegative integer")
    lr, eps = scalar(lr, "lr"), scalar(eps, "eps")
    beta = scalar(beta, "beta", upper=1, strict=False)
    beta1 = scalar(beta1, "beta1", upper=1, strict=False)
    beta2 = scalar(beta2, "beta2", upper=1, strict=False)
    velocity = np.zeros(2) if method == "momentum" else None
    m, v = (np.zeros(2), np.zeros(2)) if method == "adam" else (None, None)
    path, records = [theta.copy()], []
    for t in range(1, steps + 1):
        before, g = theta.copy(), grad(theta)
        m_hat = v_hat = None
        if method == "gd":
            update = lr * g
        elif method == "momentum":
            velocity = beta * velocity + g
            update = lr * velocity
        else:
            m = beta1 * m + (1 - beta1) * g
            v = beta2 * v + (1 - beta2) * g * g
            m_hat, v_hat = m / (1 - beta1 ** t), v / (1 - beta2 ** t)
            update = lr * m_hat / (np.sqrt(v_hat) + eps)
        theta = theta - update
        if not np.isfinite(theta).all() or not np.isfinite(loss(theta)):
            raise FloatingPointError("nonfinite iterate or loss")
        record = {"step": t, "loss_before": loss(before), "loss_after": loss(theta)}
        for name, value in (("theta_before", before), ("gradient", g), ("update", update),
                            ("theta_after", theta), ("velocity", velocity), ("m", m),
                            ("v", v), ("m_hat", m_hat), ("v_hat", v_hat)):
            record[name] = None if value is None else value.copy()
        records.append(record)
        path.append(theta.copy())
    return np.array(path), records


if __name__ == "__main__":
    for method, config in CONFIGS.items():
        path, _ = run_optimizer(method, START, **config)
print(f"{method}: theta={path[-1]}, loss={loss(path[-1]):.6f}")下载代码、CSV、检查结果与绘图脚本。包内 README 给出了隔离环境安装步骤;数值检查仅需 NumPy,绘图另外需要 Matplotlib。
python optimizer_example.py
python audit_optimizers.py --output reproduced
python plot_optimizers.py --output reproduced/loss-by-update.png
六、用同一份数据看损失反弹

paths.csv有 39 行,包含三种方法各自的起点和 12 次更新;states.csv有 36 行更新状态。后者中的 gradient 来自更新前坐标,update 是被减去的向量,theta_after 是更新后的坐标。空状态字段代表不适用,不是假设它等于零。
七、这些结果怎样复核
| 检查 | 本机实测与边界 |
|---|---|
| 历史轨迹 | 新程序的全部 39 行结果与旧 CSV 按六位小数一致;原始压缩包和等高线图片未覆盖。 |
| GD 递推 | 三种学习率各检查含起点的 51 个状态,与独立矩阵幂比较;最大坐标绝对误差约 1.14e-13。 |
| Momentum 递推 | 13 个状态与独立 4×4 状态转移矩阵幂比较,最大坐标误差约 8.88e-16。 |
| 梯度检查 | 三个固定点的六个分量,中心差分步长 1e-5;最大绝对误差约 1.40e-10。 |
| 负对照与输入 | 漏掉 Adam 偏差修正会改变首步;17 个非法输入被拒绝。另检查整数输入、零步、重复执行与输入数组未被修改。 |
| 执行环境 | Python 3.13.9、NumPy 2.3.5、float64。没有 GPU、真实训练数据、耗时测量或框架一致性测试。 |
完整数值、参数与源文件 SHA-256 见 audit.json。矩阵幂和有限差分提供不同计算路径的检查,但有限样例不是任意输入上的正确性证明。不同数值环境的末位误差可能不同。
八、内存、权重衰减与训练边界
比较内存之前必须先定统计口径。若有 P 个参数,参数、梯度与状态都使用相同的每元素 s 字节格式,并且只计原始数组载荷:
| 方法 | 数组载荷,不是峰值显存 |
|---|---|
| 无动量 GD/SGD | 参数与梯度合计 2Ps;没有参数同尺寸的历史缓冲区。本例 P=2、s=8,共 32 字节。 |
| Momentum | 另加一个 Ps 的缓冲区,总计 3Ps;本例 48 字节。 |
| Adam | 另加 m、v 两个 Ps 状态,总计 4Ps;本例 64 字节。不能说“优化器状态翻三倍”,因为无动量基线没有这些状态。 |
这里不计轨迹副本、临时数组、Python 对象、激活、混合精度主权重及分配器开销。本文程序为了审计保存了每一步的副本,实际进程内存当然不止上表大小。
权重衰减也要分清操作顺序。取全新 Adam 状态、目标函数梯度为零、参数 [2, -0.5]、lr=0.1、衰减系数 0.1、eps=1e-8:
Coupled L2: g = 0.1 * theta
theta_next = theta - 0.1*g/(abs(g)+1e-8)
           = [1.900000005, -0.400000020]

Decoupled decay:
theta_next = (1 - 0.1*0.1) * theta
           = [1.980000000, -0.495000000]
这是隔离衰减语义的一步代数实验,不是完整 AdamW 性能测试。它展示了把 L2 梯度交给自适应归一化,与直接按比例缩小参数并不等价;相关定义见解耦权重衰减论文。选择方法还要结合具体训练配置,本文不据此给所有 Transformer 指定唯一优化器。
九、如何把这个实验用于排查
先在固定函数和相同起点下检查首步,再比较逐步梯度、状态与参数,而不是只看末步 loss。若 GD 出现交替,先算主方向因子的绝对值,区分收敛振荡与发散;若 Adam 后期反弹,保留最小值所在步和完整状态,再分别改变学习率、预算或初始化,避免一次改多个变量。
迁移到真实模型时,需要另外固定数据划分、随机种子、批大小和调参预算,并同时评估验证集指标。这个小实验提供的是更新规则的排错方法,不是泛化结论。下一篇卷积与感受野继续把局部计算、矩阵实现与可复核数值对应起来。